MiniMax H3
Mãe, vou fazer uma novela?!
Dois dias testando o MiniMax H3 no meu PC pra ver até onde dá pra ir no realismo sem pagar por segundo.
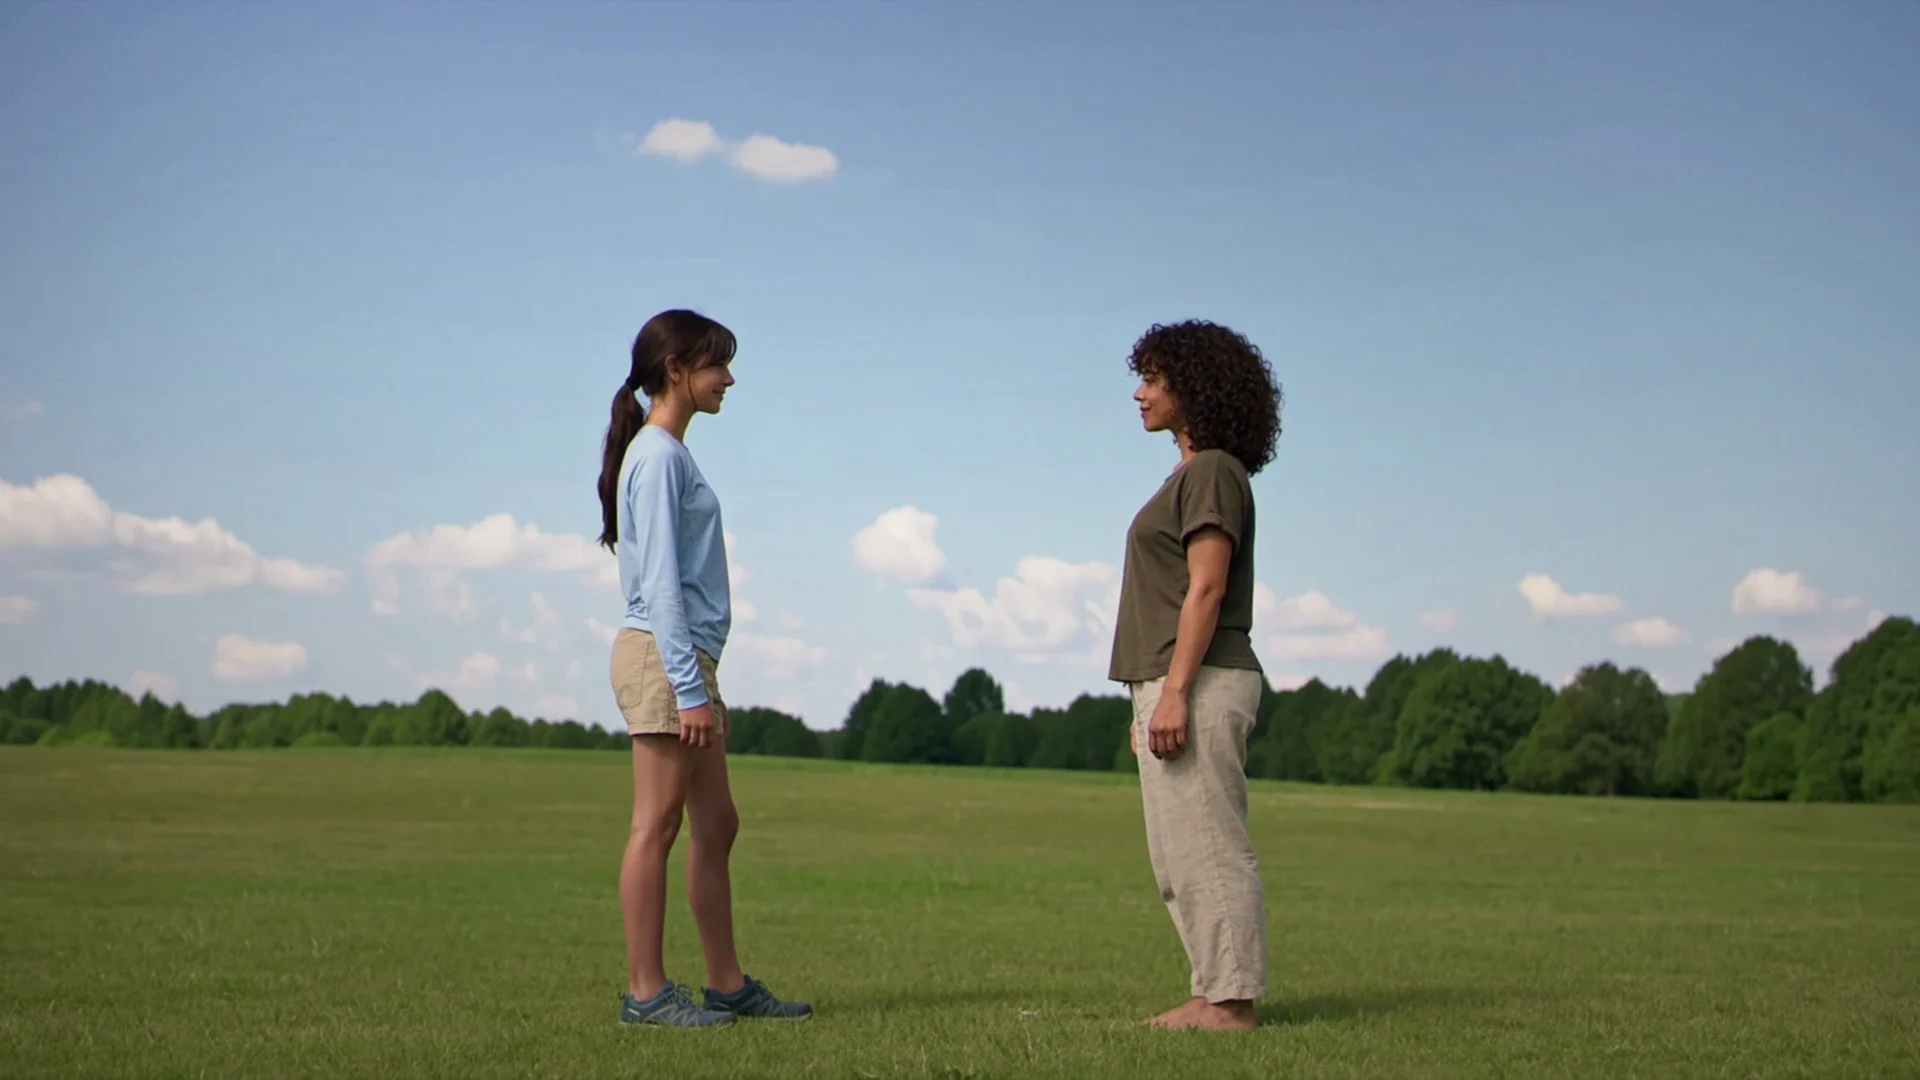
Depois do Seedance eu fiquei com uma ideia na cabeça, puxar o H3 ao máximo pra só gastar com modelo pago quando não tiver jeito.
Tudo isso saiu do meu computador, imagem, atuação, choro e a voz dela falando em português. Nenhum centavo por geração.
Por que local
No último projeto, cada take no Seedance me custou uns US$ 1,26 em draft e mais uns US$ 5,00 pra finalizar em 1080p. Parece pouco, até vc perceber que metade dos takes vem com alguma coisa errada. E aí cada erro é dinheiro.
Mas não é só o dinheiro. No local eu faço na hora que eu quiser, não pego queue… Se for um trabalho com NDA, eu sei que só eu tenho acesso àquilo, errar custa tempo e não dinheiro. E sinceramente, eu sinto que tô usando a minha máquina pro que ela foi comprada haha
Só um detalhe antes. O H3 é grátis só pra projeto não comercial. Se for usar num trabalho de cliente, confere a licença!
Rodei tudo num Ryzen 9 7950X com 96 GB de RAM e uma 4090 de 24 GB. Os tempos que eu falar aqui são baseados nesse setup.
As personagens
Antes de qualquer coisa eu precisava de duas personagens que se mantivessem iguais em todos os planos. A menina eu passei como duas imagens, uma do rosto e outra do corpo.
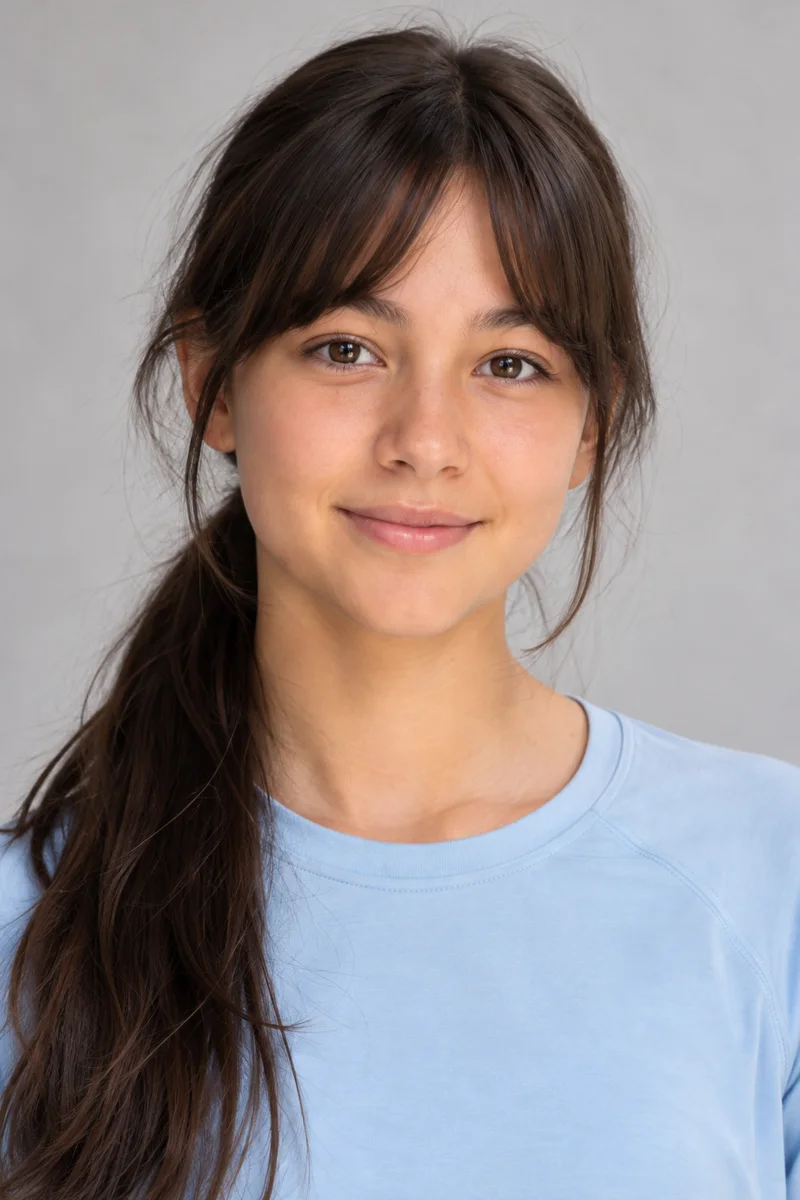
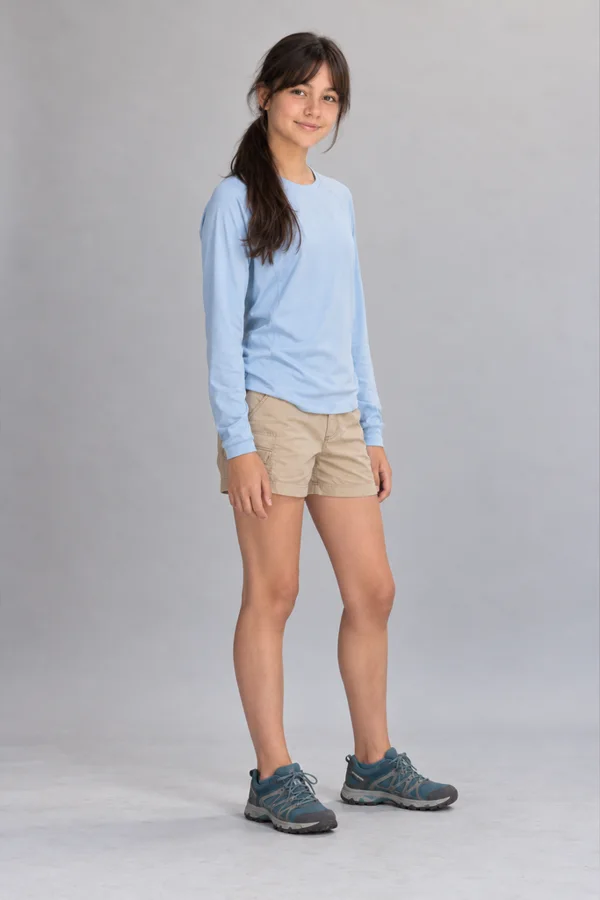
E uma das coisas que eu queria testar era o character sheet da segunda personagem. Em plano aberto, é melhor o corpo inteiro com cabeça ou sem?
No Seedance dizem que é melhor sem.
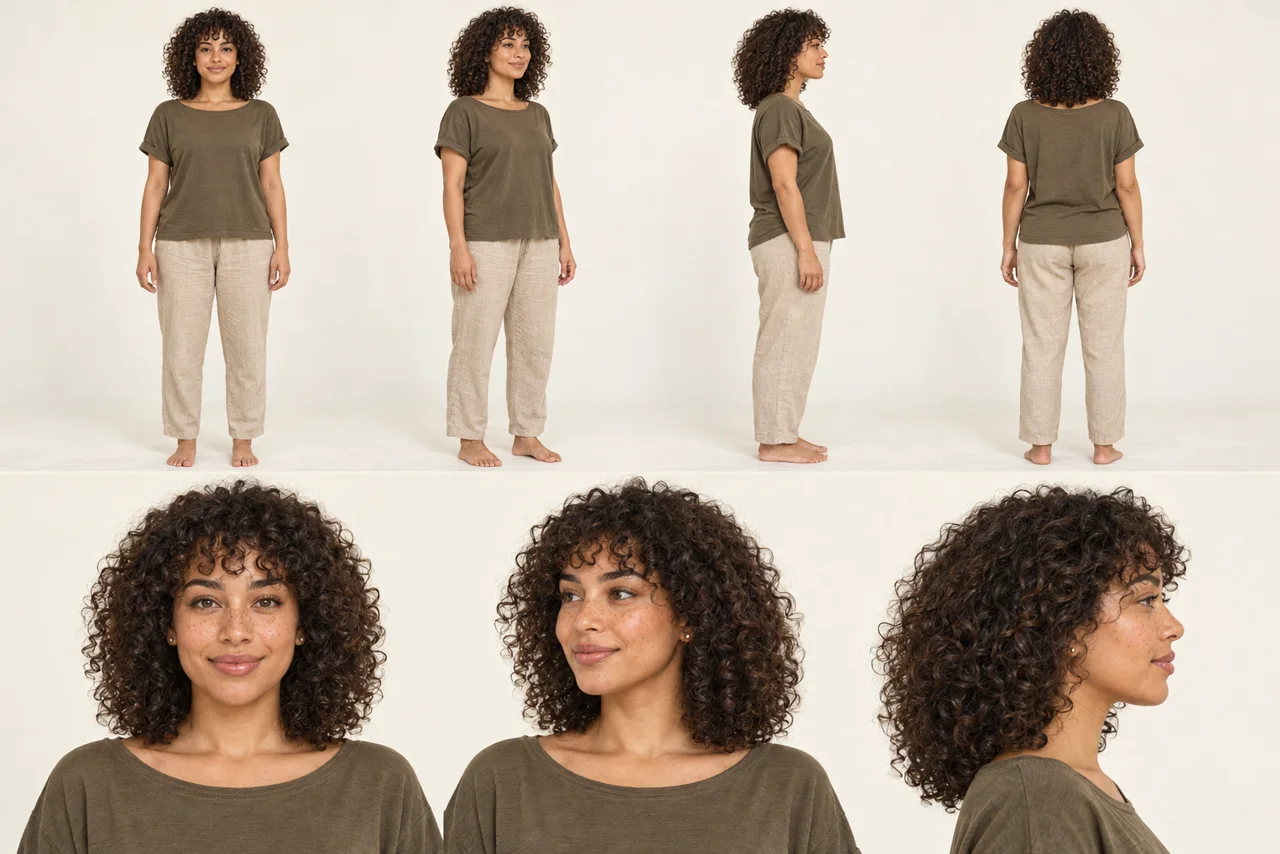
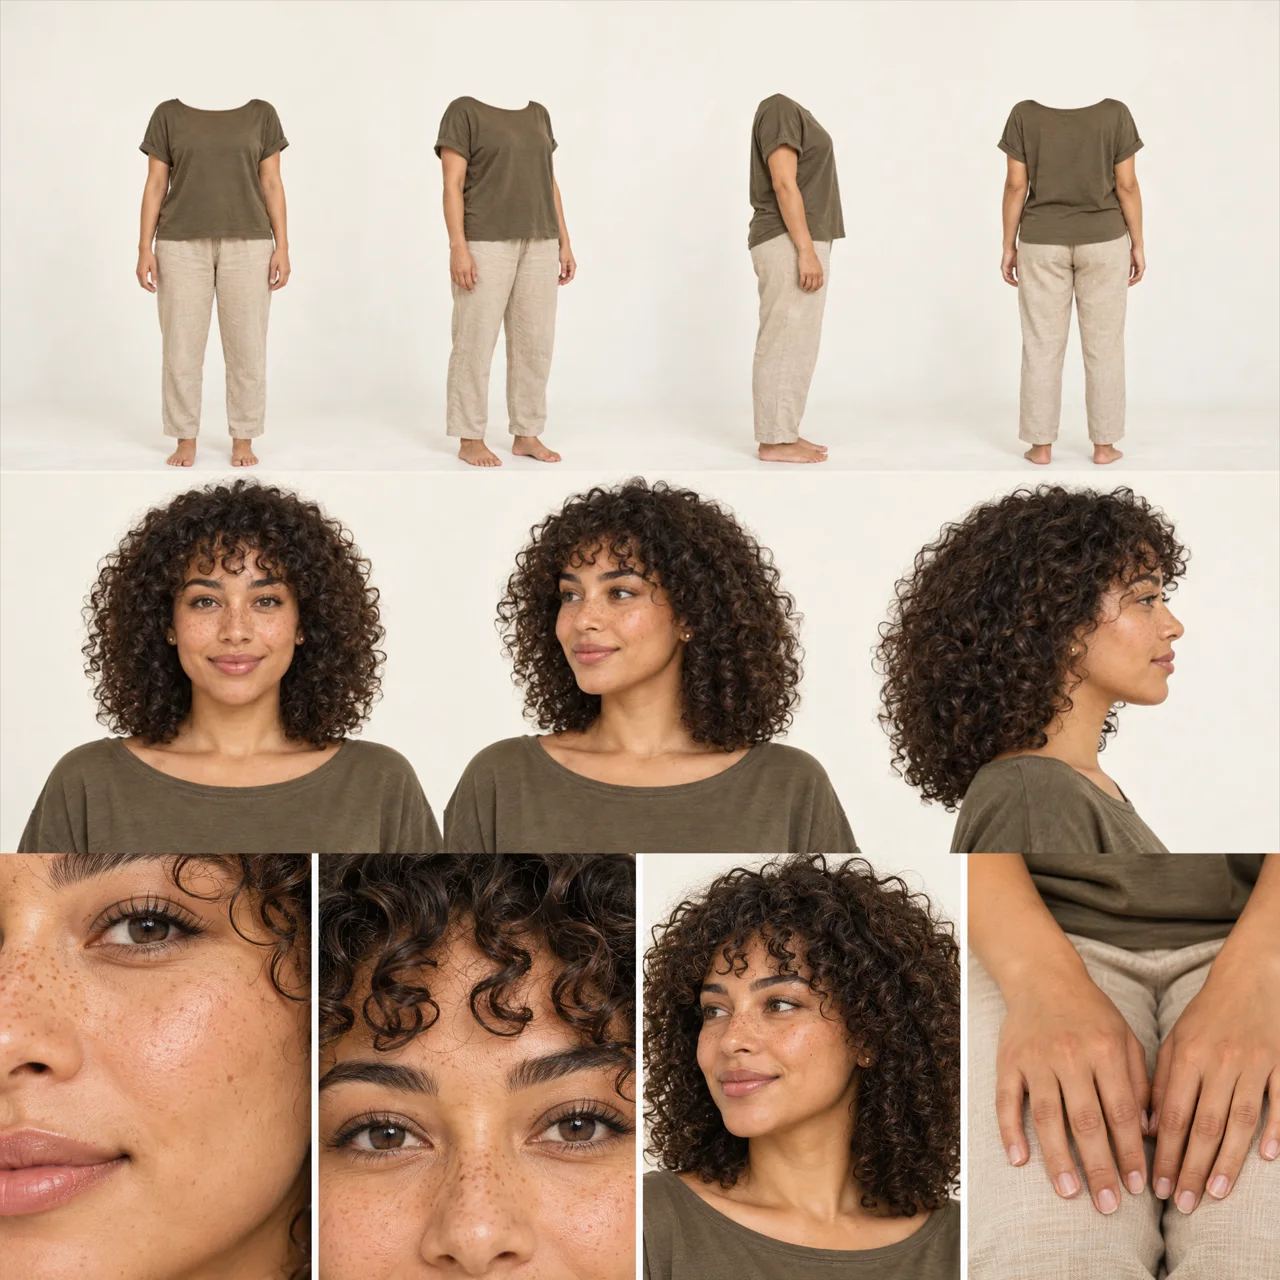
Em cima com cabeça, embaixo sem
A diferença foi pequena, o prompt pesou mais que o sheet. A versão com cabeça ficou um pouquinho mais natural.
O que pesou mesmo foi mandar o sheet inteiro. Nos primeiros testes o layout do character sheet chegava a vazar pro vídeo.
Funcionou melhor uma imagem por função, Picture 1 o rosto, Picture 2 corpo e roupa, Picture 3 a outra personagem. Se for usar o sheet, diz no prompt qual vista ele deve olhar.
O H3 aceita até 9 imagens, 3 vídeos e 3 áudios. Vale pensar em cada plano. Num plano aberto o close do rosto ajuda pouco.
Os modelos
O H3 gera imagem e som juntos, até uns 15 segundos por vez. Pra caber em 24 GB eu usei as versões pruned em int8. Fica aqui a lista, pq é o tipo de coisa que vc vai querer copiar.
| Função | O que faz | Arquivo | Pasta |
|---|---|---|---|
| Modelo DETAIL | O H3 oficial, gera a partir das referências | minimax_h3_ref2va_pruned_int8_convrot | diffusion_models |
| Modelo CINEMATIC | Híbrido da comunidade, melhor nas duas passadas | minimax_h3_hybrid_fl2va_ref2va_b25-49-int8 | diffusion_models |
| Text encoder | Lê o prompt e as imagens e traduz pro modelo | qwen3vl_32b_minimax_h3_int8_convrot | text_encoders |
| VAE de vídeo | Transforma o latente em imagem | minimax_h3_video_vae_int8_convrot | vae |
| VAE de áudio | Mesma coisa, pro som | minimax_h3_audio_vae_fp32 | vae |
| LoRA turbo | Gera com bem menos steps | lightx2v_hybrid-4to8step-Turbo_r48 | loras |
| LoRA de cinema | Dá o look de filme | 电影感loraV1.0 (eu renomeei pra H3_FilmWarm_v1) | loras |
| Upscaler latente | Aumenta o vídeo antes do refino, ainda no latente. Precisa do custom node | minimax_h3_latent_upscaler_3d_conv_v1 | latent_upscale_models |
Mas, sinceramente, liga o MCP e pede pro Claude ou pro GPT instalar tudo. Vai ser bem mais rápido.
Muitos, muitos testes
Antes de chegar no workflow final eu fiz muito teste. Comecei no turbo de 4 steps, que é rapidinho, mas vinha cheio de artefato. Depois 12 steps, depois 20, sempre olhando velocidade e custo-benefício.
12 steps me surpreendeu. Rapidinho e numa qualidade boa pra fazer um WIP, aprovar alguma cena. 20 demora um pouquinho mais, mas vale a pena pro render final.
Depois testei alguns LoRAs, resolução, e fui atrás de workflows da comunidade, no Civitai.
No fim, pro meu caso, ficou melhor ter dois caminhos, separando quando a cena tem detalhe em close e quando não tem. Juntei tudo num workflow só, com um switch que troca o model. Referências, prompt, seeds e LoRA ficam num lugar, e o switch escolhe como gerar.
Assim nada desalinha de uma versão pra outra.
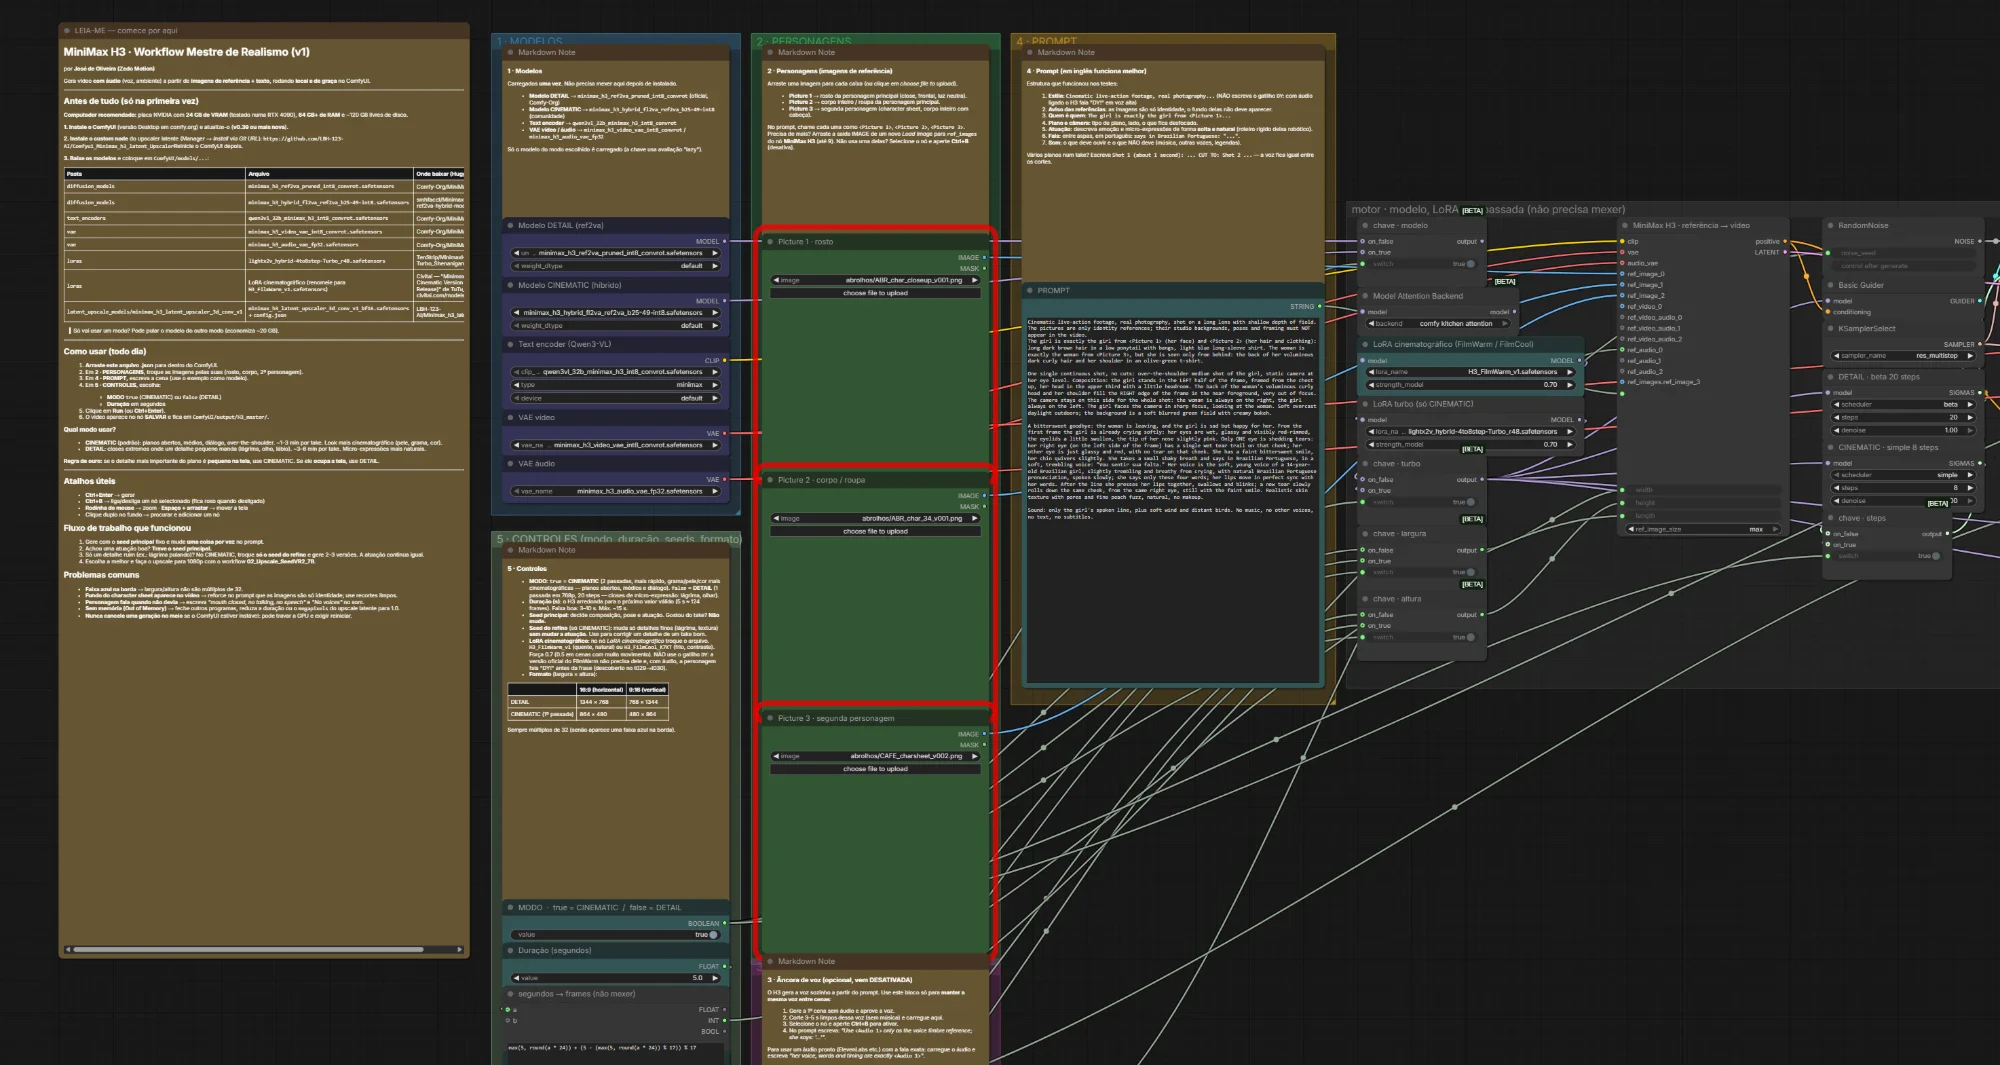
DETAIL e CINEMATIC
DETAIL é uma passada só, direto em 1344×768, 20 steps, na força bruta. Leva de 3 a 6 minutos por take de 5 segundos no meu setup.
CINEMATIC faz duas passadas. A primeira em 864×480 com 8 steps e o LoRA turbo, que decide movimento e composição. Depois um upscale no latente até 1696×928, e uma segunda passada de 4 steps com denoise 0.25, que só coloca textura sem mudar a cena.
No geral eu gostei mais do CINEMATIC. Me entregou looks com mais textura e, também, mais rápido, de 1 a 3 minutos por take. Tem motivo pra isso.
A resolução final é maior de verdade, quase 50% mais pixels que o DETAIL. A textura de pele, grama e cabelo nasce na passada de refino. E as referências entram em 2048 px, o que ajuda a segurar o rosto.
1344×7681696×928Aqui, nesse tamanho, nem eu tô vendo muito problema na grama do DETAIL. Mas em 4K ela cria um pattern muito estranho, aquela textura de IA. No CINEMATIC isso diminui.
Porém…
A lágrima de gel
No close de choro o CINEMATIC me deu uma lágrima grossa, parecendo gel de cabelo. Faz sentido quando vc pensa. Na primeira passada em 480p uma lágrima fina não cabe, vira uma gota gorda, e o refino não consegue afinar depois.
Então a regra ficou assim. Se é um close, uma imagem com detalhes, vou de DETAIL. Se é uma cena mais aberta, sem tantos detalhes, vou de CINEMATIC. Fácil, não? hahaha
E outra coisa sobre o choro. Eu não usei nenhuma imagem dela chorando, foi tudo prompt.
O truque do seed de refino
Essa foi a melhor descoberta. No CINEMATIC tem dois seeds, um de cada passada. Se vc gostou da atuação mas um detalhe saiu ruim, trava o primeiro e troca só o do refino. A atuação, a fala, o enquadramento e o tempo ficam iguais, e só os detalhes finos são redesenhados.
Aqui a lágrima pulava da bochecha pro queixo. Três seeds de refino e resolveu.
Agora, qualquer outra coisa que vc mudar, uma palavra no prompt, a resolução, o LoRA, uma referência, e é outro take. Mesmo com o seed igual.
O LoRA muda até a atuação
Testei o mesmo take, mesmos seeds, mesmo prompt, trocando só o LoRA de cinema. Eu esperava mudar a cor, a textura. Mudou a atuação também, mais ou menos dramática… o LoRA mexe no modelo inteiro.
A voz
Aqui eu me surpreendi. O H3 gera a voz sozinho, sem nenhum áudio de referência, em português, com sincronia labial. É só descrever a voz no prompt e colocar a fala entre aspas.
Primeiro testei com uma voz que eu fiz no ElevenLabs entrando como referência, depois sem nada, deixando o H3 inventar. Liga o som.
Primeiro com a voz do ElevenLabs, depois a voz gerada pelo H3
Pessoalmente eu ainda prefiro o ElevenLabs. Mas o H3 entregou muita qualidade, e poder manter tudo no mesmo lugar deixa o workflow bem mais simples. Se eu preciso mudar a voz, o texto ou a entonação, mudo no prompt, não fico indo e voltando do ElevenLabs.
O problema é que cada geração começa do zero, então numa cena nova a voz pode mudar. Pra resolver isso eu usei a voz que eu já tinha aprovado e passei como <Audio 1>, dizendo pra usar só o timbre.
Use <Audio 1> only as the voice timbre reference. Do NOT repeat the words or the emotion of <Audio 1>.Funcionou. Cena nova, ela alegre segurando uma beterraba, fala nova, mesma voz.
Di Uai!
Ouviu um “Di Uai!” antes da frase? Pois é. Achei que era chinês, sei lá. Reforcei no prompt “só português, nada antes do Eu”, mesmo seed, e nada.
Foi aí que caiu a ficha. Eu tava usando DY no começo do prompt, que era o gatilho do LoRA. Com áudio ligado, o H3 lê tudo que parece palavra como fala. Ela tava literalmente falando o nome do LoRA haha
Com o DY no prompt, depois sem, mesmo seed
Tirei o DY e a fala saiu limpa na hora. A versão nova do FilmWarm nem precisa de gatilho. Então com áudio, prompt sem palavra estranha.
O prompt
O prompt eu falo com o Claude por áudio, em português mesmo. Ele passa pro inglês, com as falas dos personagens em português entre aspas.
Cinematic live-action footage, real photography, shot on a long lens with shallow depth of field. The pictures are only identity references; their studio backgrounds, poses and framing must NOT appear in the video. The girl is exactly the girl from <Picture 1> (her face) and <Picture 2> (her hair and clothing). Over-the-shoulder medium shot of the girl. A bittersweet goodbye: the woman is leaving, and the girl is sad but happy for her. She says in Brazilian Portuguese, in a soft, trembling voice: "Vou sentir sua falta." Sound: only the girl's spoken line, plus soft wind and distant birds. No music, no other voices, no text, no subtitles.Se vc quer silêncio, tem que pedir com todas as letras, “completely silent, mouth closed, no talking”. Senão ela fala sozinha, olha esse dos primeiros testes. Ninguém pediu pra ela falar nada haha
Dá pra fazer mais de um plano numa geração só também, escrevendo Shot 1 ... CUT TO: Shot 2 no prompt. A voz, a luz e a roupa ficam iguais entre os cortes, e inclusive foi a melhor forma que encontrei pra ter coerência no background sem usar nenhuma imagem de referência.
Ah, e se vc reparar que o fundo muda entre os takes, é pq o meu foco aqui foi atuação, eu fiz vários takes em modelos diferentes e fui pegando o que mais gostei.
Resolução e upscale
Largura e altura sempre múltiplas de 32. Em 720 de altura apareceu uma faixa azulada na borda, em 768 sumiu.
Repara na faixa azul lá embaixo
E a resolução de geração pesa muito mais que o upscale. Os rostos no plano aberto melhoraram muito gerando em 768 em vez de 576. O upscale não inventa o detalhe que não foi gerado.
Pro upscale eu deixei um workflow separado de propósito. Gera vários takes, escolhe o melhor, e só ele vai pra 1080p. Testei três.
Da esquerda pra direita: original esticado, SeedVR2 3B, SeedVR2 7B e Wan 2.2
O 3B é mais rápido, nítido e contrastado, com certeza ele tem o lugar dele. Mas nesse projeto eu senti o 7B melhor, mais natural.
O Wan 2.2 me agradou em alguns momentos. Só que ele não dá upscale, ele recria a cena. Repara que o rosto já é outro, e isso pode ser um problema. E a falta de VRAM limitou muito o teste. Não rodou só na 4090, teve que dividir com a RAM, e aí é deixar o PC inteiro à disposição dele. Preferi abandonar. Talvez se vc tiver uma 5090…
O que ainda pega
- VRAM. O quanto vc puder, 24 GB é o mínimo confortável;
- Até 15 segundos por geração;
- Fora o truque do refino, não dá pra ajustar uma coisa só. Mudou, é outro take;
- O ComfyUI pesa, nada de CS enquanto renderiza :/
Os dois workflows estão lá em cima pra baixar, com as instruções em português dentro do próprio ComfyUI. Se vc for testar e achar um jeito melhor de segurar os personagens ou a voz entre cenas, me conta. tmj!
José De Oliveira